
NDV Pipeline - IAEA
Introduzione
Questa pipeline elabora campioni di Newcastle Desease Virus (NDV), effenduando una deplezione delle read dell'ospite, determinando automaticamente la sequenza reference e ricostruendo la sequenza consensus corrispondente.
- Pagina ufficiale del dataset: https://github.com/NDVconsortium/NDV_Sequence_Datasets/tree/master

Come eseguire la pipeline
Una volta selezionata l'analisi NDV Pipeline nella pagina dedicata al lancio di analisi, il sistema passerà ad un'interfaccia di conferma che permetterà di procedere con la selezione dei parametri.
La NDV Pipeline prevede 3 fasi principali:
- deplezione delle read dell'ospite
- identificazione del miglior reference;
- mapping e generazione consensus.
Dal menù a tendina è possibile scegliere l'host con cui effettuare la deplezione.
In seguito, si può selezionare l'input che, per questa analisi, è di tipo trimmed reads.
Screenshot della selezione degli input e dei parametri 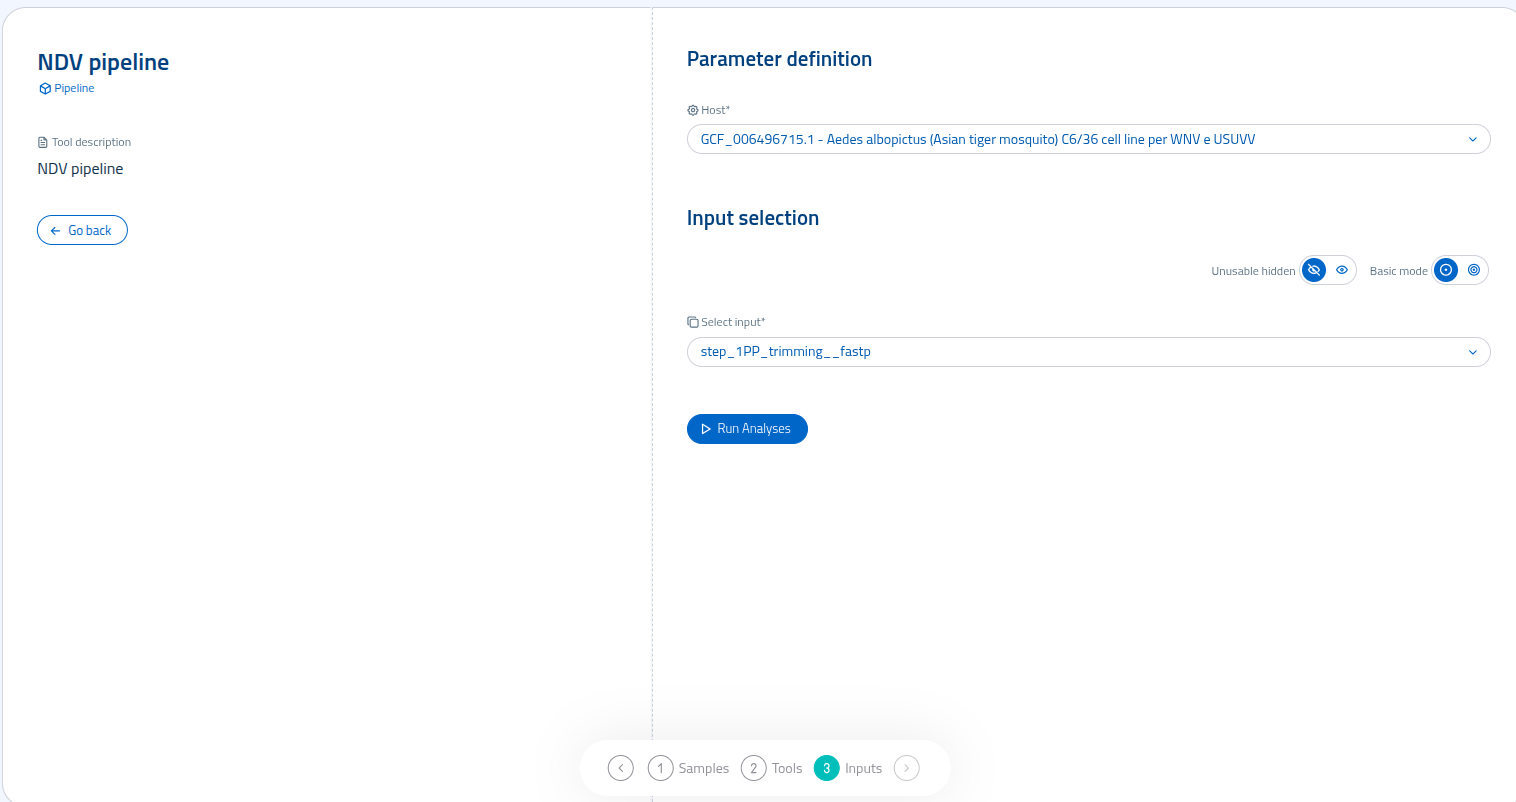
Una volta lanciata l'analisi, la pagina genererà un link alla sezione Controllo analisi, per permettere di verificare lo stato del processo. L'utente verrà notificato dal sistema sia una volta lanciata con successo l'analisi, sia al termine dell'esecuzione.
Cartella dei risultati
La cartella dei risultati, Result folder, è accessibile cliccando sul link presente all'interno della scheda dell'analisi, nella sezione Dati risultato. All'interno della conseguente cartella results, è possibile trovare due sottocratelle:
- meta: (metadati), in cui vengono salvati i file di log e di configurazione del processo eseguito;
- result: in cui sono salvati i file con i risultati prodotti dall'analisi.